Em đang tìm một đề kiểm tra giữa kỳ 1 Tin học 12 có đáp án để tự ôn trước kỳ kiểm tra thật ở trường? Đây là đề do ClassOn biên soạn theo sách Kết nối tri thức với cuộc sống, đúng cấu trúc đề kiểm tra định kỳ cấp THPT hiện hành, gồm 20 câu: Phần I có 12 câu trắc nghiệm nhiều lựa chọn (3,0 điểm), Phần II có 2 câu trắc nghiệm đúng – sai (2,0 điểm), Phần III có 4 câu trả lời ngắn (2,0 điểm) và Phần IV có 2 bài tự luận (3,0 điểm), làm bài trong 90 phút. Nội dung phủ các chủ đề mở đầu của Tin học 12: trí tuệ nhân tạo và học máy cùng mặt trái đạo đức của AI như thiên lệch dữ liệu và deepfake; mạng máy tính và bảo mật thông tin ở phần đầu; khoa học dữ liệu ở mức giới thiệu, kèm bài tập lập trình Python xử lí dữ liệu thống kê.
Bài viết này in trọn bộ cho em: ma trận đề, toàn bộ đề bài, bảng đáp án nhanh, giải thích chi tiết từng câu trắc nghiệm (với các câu đọc chương trình, phần giải thích sẽ chạy thử từng bước — kể cả vòng lặp có bước nhảy và hàm tự định nghĩa), phân tích từng ý của hai câu đúng – sai, đáp án phần trả lời ngắn và gợi ý chấm tự luận theo từng bước điểm, kèm thang điểm đầy đủ để em tự đối chiếu sau khi làm.
Nhưng khoan mở phần đáp án vội. Hãy tự làm đề một lượt như thi thật — bấm giờ 90 phút, không tra cứu — rồi mới quay lại xem mình hay mất điểm ở đâu: lẫn lộn chương trình truyền thống với học máy, đọc sai range có bước nhảy, hay vội tin một cuộc gọi video "người thân gặp nạn" mà quên kiểm chứng. Em có thể làm đề trực tuyến trên ClassOn để có đồng hồ bấm giờ như phòng thi và được chấm tự động phần trắc nghiệm; xem đề không cần đăng nhập và hoàn toàn miễn phí.
Thông tin chung về đề thi
- Môn: Tin học — Lớp: 12 — Kỳ thi: Giữa kỳ 1, năm học 2026–2027
- Bộ sách: Kết nối tri thức với cuộc sống (KNTT)
- Thời gian làm bài: 90 phút — Thang điểm: 10,0 điểm
- Cấu trúc: 20 câu. Phần I — Trắc nghiệm nhiều lựa chọn gồm 12 câu (mỗi câu 0,25 điểm, tổng 3,0 điểm). Phần II — Trắc nghiệm đúng – sai gồm 2 câu, mỗi câu 4 ý (mỗi câu 1,0 điểm, tổng 2,0 điểm, chấm lũy tiến). Phần III — Trắc nghiệm trả lời ngắn gồm 4 câu (mỗi câu 0,5 điểm, tổng 2,0 điểm). Phần IV — Tự luận gồm 2 bài (mỗi bài 1,5 điểm, tổng 3,0 điểm)
- Tỉ lệ trắc nghiệm khách quan / tự luận: 70% / 30% — đúng chuẩn cấu trúc đề kiểm tra định kỳ cấp THPT
- Phân bổ mức độ: Biết 4,0 điểm (40%) — Hiểu 3,0 điểm (30%) — Vận dụng 3,0 điểm (30%). Khoảng 70% số điểm nằm ở hai mức Biết và Hiểu, nên nắm chắc hệ khái niệm AI – học máy – dữ liệu lớn – bảo mật là em đã giữ được phần lớn điểm của đề
- Giá trị của đề: cấu trúc bốn phần bám sát định dạng đề kiểm tra định kỳ THPT hiện hành (nhiều lựa chọn, đúng – sai, trả lời ngắn, tự luận). Điểm riêng của đề Tin học 12 là tính thời sự: các câu hỏi vận dụng đều là tình huống đang diễn ra ngoài đời — hệ thống gợi ý video, AI nhận diện khuôn mặt bị thiên lệch, cuộc gọi video deepfake lừa chuyển tiền — nên đề kiểm tra đồng thời cả kiến thức lẫn năng lực số của một công dân sắp tốt nghiệp
- Hình thức: Làm online trên ClassOn có bấm giờ và chấm tự động phần trắc nghiệm khách quan; phần tự luận em đối chiếu bài làm của mình với gợi ý chấm và thang điểm từng bước trong bài này để tự chấm và rút kinh nghiệm
Phạm vi kiến thức của đề
Đề bám tiến độ nửa đầu học kỳ 1 Tin học 12 KNTT, phủ ba mảng nội dung:
- Chủ đề 1 — Trí tuệ nhân tạo và ứng dụng: khái niệm trí tuệ nhân tạo (AI); học máy ở mức giới thiệu — hệ thống tự rút ra quy luật từ dữ liệu huấn luyện, khác biệt cốt lõi với chương trình truyền thống viết sẵn quy tắc; các ứng dụng tiêu biểu của AI như trợ lí ảo nhận dạng giọng nói, hệ thống gợi ý nội dung; vấn đề thiên lệch dữ liệu khiến mô hình thiếu công bằng; đạo đức và trách nhiệm khi phát triển, sử dụng AI, trong đó có thông tin giả mạo sâu (deepfake).
- Chủ đề 2 (phần đầu) — Mạng máy tính và bảo mật thông tin: giao thức HTTPS và mã hoá dữ liệu; tường lửa (firewall); xác thực hai yếu tố (2FA); mã độc tống tiền (ransomware); nhận diện lừa đảo giả mạo qua các kênh liên lạc số.
- Chủ đề 3 (mức giới thiệu) — Khoa học dữ liệu: khái niệm dữ liệu lớn (Big Data) với các đặc trưng khối lượng, đa dạng, tốc độ (3V); quy trình khoa học dữ liệu — thu thập, làm sạch và tiền xử lí, phân tích, trực quan hoá và công bố kết quả.
- Kèm bài tập lập trình Python xử lí dữ liệu: vòng lặp có bước nhảy range(a, b, bước), hàm tự định nghĩa có return, thống kê trên danh sách (tính trung bình, đếm phần tử thoả mãn điều kiện nhiệt độ).
Đề chưa đưa vào các chủ đề chuyên sâu của nửa sau học kỳ 1 và phần ôn tập thi tốt nghiệp — đó là nội dung của các đợt đề sau. Một lưu ý hữu ích: trí tuệ nhân tạo, dữ liệu lớn và an toàn thông tin là những nội dung mang tính phổ quát, xuất hiện trong mọi bộ sách Tin học 12 hiện hành với cùng hệ khái niệm cốt lõi. Dù lớp em học bộ sách nào, em vẫn dùng đề này để ôn đúng phần kiến thức mở đầu của giữa kỳ 1.
Ma trận đề
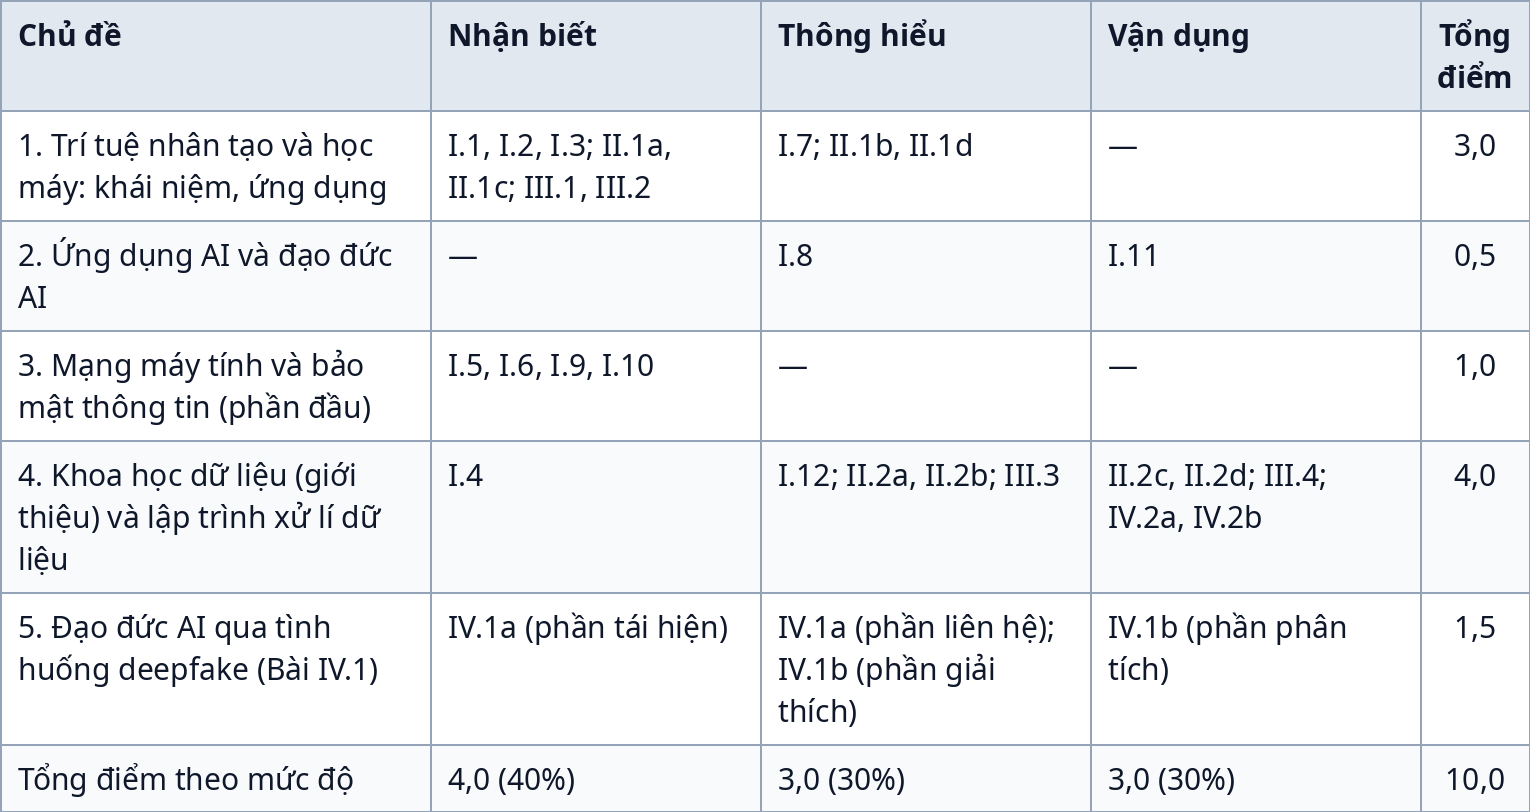
Nhìn vào ma trận, có hai điều em cần nhớ. Thứ nhất, mảng khoa học dữ liệu kết hợp lập trình xử lí dữ liệu nặng điểm nhất (4,0 điểm) và là mảng duy nhất xuất hiện ở cả bốn phần của đề — từ khái niệm dữ liệu lớn, quy trình làm sạch dữ liệu, cho đến hai câu đọc chương trình và cả Bài 2 Phần IV viết chương trình thống kê nhiệt độ. Ôn mảng này là ưu tiên số một. Thứ hai, toàn bộ mảng AI (3,0 điểm) cùng hai câu vận dụng về đạo đức AI đều xoay quanh một trục tư duy duy nhất: mô hình học từ dữ liệu, nên chất lượng của mô hình phụ thuộc vào dữ liệu — dữ liệu thiếu đại diện hoặc chứa định kiến thì kết quả sẽ thiên lệch. Nắm được trục này, các câu về hệ thống gợi ý, nhận diện khuôn mặt và deepfake đều trở thành cùng một bài toán.
Đề bài đầy đủ
Phần I — Trắc nghiệm nhiều lựa chọn (3,0 điểm)
Mỗi câu chỉ có một đáp án đúng. Mỗi câu đúng được 0,25 điểm.
Câu 1. Trí tuệ nhân tạo (AI — Artificial Intelligence) là lĩnh vực của khoa học máy tính nghiên cứu
A. cách lắp ráp các linh kiện phần cứng của máy tính.
B. việc xây dựng các hệ thống máy tính có khả năng thực hiện những công việc vốn cần đến trí tuệ của con người.
C. cách thiết kế giao diện cho các trang web.
D. việc lưu trữ dữ liệu lên các dịch vụ đám mây.
Câu 2. Học máy (Machine Learning) là một phương pháp của trí tuệ nhân tạo, trong đó
A. máy tính phải được lập trình viên viết sẵn quy tắc cho mọi tình huống có thể xảy ra.
B. con người phải nhập từng kết quả bằng tay cho máy.
C. máy tính chỉ hoạt động được khi có kết nối Internet.
D. hệ thống tự rút ra các quy luật từ dữ liệu để dự đoán hoặc đưa ra quyết định.
Câu 3. Ứng dụng nào sau đây là ứng dụng tiêu biểu của trí tuệ nhân tạo?
A. Trợ lí ảo trên điện thoại có thể nhận dạng giọng nói và trả lời câu hỏi.
B. Máy tính bỏ túi thực hiện phép cộng hai số.
C. Phần mềm cho phép gõ văn bản thuần tuý, không có tính năng thông minh.
D. Đồng hồ cơ học lên dây cót.
Câu 4. Dữ liệu lớn (Big Data) thường được mô tả bằng các đặc trưng nào sau đây?
A. Khối lượng ít, dạng đơn giản, ít thay đổi.
B. Chỉ bao gồm dữ liệu dạng văn bản.
C. Khối lượng rất lớn, đa dạng về dạng dữ liệu và tốc độ phát sinh nhanh.
D. Chỉ tồn tại dưới dạng giấy tờ, sổ sách.
Câu 5. Biện pháp nào sau đây giúp bảo vệ tài khoản trực tuyến tốt hơn?
A. Bật tính năng xác thực hai yếu tố (2FA) cho tài khoản.
B. Dùng chung một mật khẩu cho tất cả các tài khoản.
C. Đặt mật khẩu chính là ngày tháng năm sinh của mình.
D. Chia sẻ mật khẩu với bạn thân để nhờ giữ hộ.
Câu 6. Mã độc tống tiền (ransomware) là loại phần mềm độc hại có hành vi
A. giúp máy tính khởi động và chạy nhanh hơn.
B. mã hoá dữ liệu của nạn nhân rồi đòi tiền chuộc để mở khoá.
C. tự động dọn dẹp các tệp rác trong hệ thống.
D. hỗ trợ sao lưu dữ liệu lên đám mây.
Câu 7. Điểm khác biệt cốt lõi giữa một chương trình truyền thống và một hệ thống học máy là
A. hệ thống học máy luôn chạy chậm hơn chương trình truyền thống.
B. chương trình truyền thống hoàn toàn không cần đến dữ liệu.
C. hệ thống học máy tự hình thành cách giải quyết vấn đề từ dữ liệu huấn luyện, thay vì được viết sẵn mọi quy tắc xử lí.
D. hệ thống học máy không cần sử dụng thuật toán nào.
Câu 8. Vì sao một hệ thống AI nhận diện khuôn mặt có thể cho kết quả thiếu chính xác và thiếu công bằng đối với một nhóm người dùng nhất định?
A. Vì máy tính của người dùng đã quá cũ.
B. Vì màn hình hiển thị sai màu sắc.
C. Vì mọi hệ thống AI đều tự động từ chối phục vụ người lạ.
D. Vì dữ liệu huấn luyện thiếu tính đại diện hoặc chứa sẵn định kiến, khiến mô hình học theo sự thiên lệch đó.
Câu 9. Giao thức HTTPS khác giao thức HTTP chủ yếu ở điểm nào?
A. HTTPS giúp trang web tải nhanh hơn hẳn.
B. Dữ liệu truyền qua HTTPS được mã hoá nên an toàn hơn.
C. HTTPS chỉ dùng cho các trang web giải trí.
D. HTTPS không cần trình duyệt để truy cập.
Câu 10. Tường lửa (firewall) trong hệ thống mạng có chức năng chính là
A. kiểm soát, lọc lưu lượng mạng ra vào theo các quy tắc an toàn, ngăn chặn truy cập trái phép.
B. tăng thêm dung lượng cho ổ cứng của máy chủ.
C. soạn thảo và định dạng văn bản.
D. kết nối máy tính với máy in trong văn phòng.
Câu 11. Bạn nhận được một cuộc gọi video từ tài khoản của người thân: hình ảnh và giọng nói rất giống, người này yêu cầu bạn chuyển tiền gấp vì "đang gặp nạn" và dặn không được nói với ai. Hành động đúng nhất là
A. chuyển tiền ngay vì hình ảnh và giọng nói rõ ràng, đáng tin.
B. quay lại đoạn video rồi đăng lên mạng xã hội để hỏi ý kiến.
C. mặc kệ, chờ đến hôm sau mới xử lí.
D. bình tĩnh kiểm chứng bằng cách gọi lại qua số điện thoại quen thuộc hoặc hỏi một chi tiết chỉ người thân thật mới biết, vì đây có thể là sản phẩm giả mạo sâu (deepfake).
Câu 12. Trong quy trình khoa học dữ liệu, ngay sau bước thu thập dữ liệu, bước tiếp theo thường là
A. công bố kết quả phân tích ngay cho người dùng.
B. huấn luyện mô hình ngay trên dữ liệu thô.
C. làm sạch và tiền xử lí dữ liệu (xử lí dữ liệu thiếu, trùng lặp, sai định dạng).
D. xoá bỏ toàn bộ dữ liệu gốc đã thu thập.
Phần II — Trắc nghiệm đúng–sai (2,0 điểm)
Mỗi câu 1,0 điểm, gồm 4 ý a), b), c), d). Điểm được tính lũy tiến theo số ý trả lời đúng: đúng 1 ý được 0,1 điểm; đúng 2 ý được 0,25 điểm; đúng 3 ý được 0,5 điểm; đúng cả 4 ý được 1,0 điểm.
Câu 1. Một nền tảng xem video trực tuyến sử dụng hệ thống gợi ý: hệ thống theo dõi lịch sử xem của từng người dùng và ngày càng đề xuất chính xác hơn những video mà người dùng có khả năng thích. Xét tính đúng – sai của các khẳng định sau:
a) Việc hệ thống tự cải thiện chất lượng gợi ý dựa trên dữ liệu hành vi của người dùng là một biểu hiện của học máy.
b) Để hệ thống gợi ý hoạt động, lập trình viên bắt buộc phải viết sẵn quy tắc gợi ý cho từng người dùng và từng video cụ thể.
c) Nếu dữ liệu huấn luyện thiếu đa dạng, các gợi ý của hệ thống có thể bị thiên lệch, chỉ tập trung vào một số loại nội dung nhất định.
d) Mọi hệ thống trí tuệ nhân tạo hiện nay đều đã có khả năng tư duy và cảm xúc giống như con người.
Câu 2. Cho đoạn chương trình Python sau:
diem = [8, 5, 9, 4, 7] dem = 0 for d in diem: if d >= 5: dem = dem + 1 print(dem)Xét tính đúng – sai của các khẳng định sau về đoạn chương trình trên:
a) Chương trình đếm số phần tử trong danh sách diem có giá trị lớn hơn hoặc bằng 5.
b) Khi chạy chương trình, kết quả in ra màn hình là 5.
c) Biến dem tăng thêm 1 mỗi lần vòng lặp gặp một phần tử có giá trị lớn hơn hoặc bằng 5.
d) Nếu thay điều kiện d >= 5 bằng điều kiện d > 5 thì kết quả in ra vẫn là 4.
Phần III — Trắc nghiệm trả lời ngắn (2,0 điểm)
Mỗi câu 0,5 điểm. Chỉ ghi đáp án ngắn gọn (cụm từ viết tắt, tên gọi hoặc kết quả chương trình).
Câu 1. Trong tiếng Anh, cụm từ "trí tuệ nhân tạo" được viết tắt là gì?
Câu 2. Trong học máy, tập dữ liệu được dùng để cho mô hình học các quy luật trong giai đoạn huấn luyện được gọi là gì?
Câu 3. Cho đoạn chương trình Python sau:
s = 0 for i in range(1, 7, 2): s = s + i print(s)Hỏi khi chạy chương trình, kết quả in ra màn hình là số nào?
Câu 4. Cho đoạn chương trình Python sau:
def tb(a, b): return (a + b) / 2 print(tb(6, 9))Hỏi khi chạy chương trình, kết quả in ra màn hình là số nào?
Phần IV — Tự luận (3,0 điểm)
Bài 1 (1,5 điểm). Đọc tình huống sau: "Gần đây, trên mạng xã hội xuất hiện một đoạn video ngắn cho thấy một người nổi tiếng đang phát biểu những điều gây tranh cãi. Video lan truyền rất nhanh và khiến nhiều người bức xúc, chia sẻ lại kèm bình luận gay gắt. Tuy nhiên, sau đó cơ quan chức năng xác minh: đây là video giả mạo sâu (deepfake) — khuôn mặt và giọng nói của người nổi tiếng đã bị công nghệ trí tuệ nhân tạo ghép, chỉnh sửa từ một video khác; người đó hoàn toàn không nói những điều như trong video."
a) (0,75 điểm) Nêu những tác hại mà video deepfake trong tình huống có thể gây ra cho cá nhân người bị giả mạo và cho cộng đồng mạng.
b) (0,75 điểm) Phân tích trách nhiệm của người sử dụng mạng xã hội khi tiếp nhận và chia sẻ thông tin dạng video trên mạng, đồng thời đề xuất những nguyên tắc cần tuân thủ để việc phát triển và sử dụng trí tuệ nhân tạo mang lại lợi ích cho xã hội.
Bài 2 (1,5 điểm). Cho danh sách nhiệt độ cao nhất trong ngày (đơn vị: độ C) của một địa phương trong 7 ngày liên tiếp: nhiet = [31, 33, 30, 35, 32, 34, 33].
a) (0,75 điểm) Viết chương trình Python tính và in ra nhiệt độ trung bình của 7 ngày trong danh sách trên.
b) (0,75 điểm) Bổ sung vào chương trình để đếm và in ra số ngày được coi là nóng (nhiệt độ từ 33 độ C trở lên). Nêu rõ kết quả mà chương trình in ra với dữ liệu đã cho.
— Hết đề —
Đáp án và giải thích chi tiết
Bảng đáp án nhanh Phần I (Câu 1–12)

Đáp án phân bố đều tuyệt đối: A, B, C, D mỗi phương án đúng đúng 3 câu (A: 3, 5, 10; B: 1, 6, 9; C: 4, 7, 12; D: 2, 8, 11). Hãy làm chắc từng câu theo phần giải thích dưới đây thay vì đoán theo quy luật — quy luật phân bố chỉ nên dùng để soát lại bài khi đã làm xong.
Giải thích từng câu Phần I
Câu 1 — Đáp án B.
Trí tuệ nhân tạo (AI) là lĩnh vực của khoa học máy tính nghiên cứu việc xây dựng các hệ thống máy tính có khả năng thực hiện những công việc vốn cần đến trí tuệ của con người: học tập, suy luận, nhận dạng hình ảnh và giọng nói, hiểu ngôn ngữ, ra quyết định. Ba phương án còn lại đều là những mảng việc khác hẳn: lắp ráp phần cứng là công việc của kĩ thuật phần cứng, thiết kế giao diện web là của thiết kế đồ hoạ – lập trình giao diện, lưu trữ đám mây là một dịch vụ chứ không phải một lĩnh vực nghiên cứu trí tuệ.
Câu 2 — Đáp án D.
Bản chất của học máy nằm ở chỗ: hệ thống tự rút ra các quy luật từ dữ liệu để dự đoán hoặc đưa ra quyết định, thay vì được con người viết sẵn quy tắc cho mọi tình huống. Lập trình viên cung cấp dữ liệu huấn luyện và thuật toán học; còn "quy tắc" xử lí — tức mô hình — do hệ thống tự hình thành trong quá trình học.
Phương án A mô tả đúng chương trình truyền thống, và sự đối lập giữa A và D chính là trục kiến thức quan trọng nhất của cả chủ đề, sẽ còn quay lại ở Câu 7 và ý b Câu 1 Phần II.
Câu 3 — Đáp án A.
Trợ lí ảo trên điện thoại nhận dạng được giọng nói và trả lời câu hỏi là ứng dụng tiêu biểu của AI, vì nó dùng các kĩ thuật nhận dạng tiếng nói và xử lí ngôn ngữ tự nhiên — những công việc cần "trí tuệ". Máy tính bỏ túi chỉ thực hiện phép tính theo mạch cố định, phần mềm gõ văn bản thuần tuý không có tính năng thông minh nào, đồng hồ cơ học thì không liên quan đến máy tính. Tiêu chí phân biệt: hệ thống có học hỏi, nhận dạng hoặc suy luận hay không.
Câu 4 — Đáp án C.
Dữ liệu lớn (Big Data) thường được mô tả bằng ba đặc trưng gọi tắt là 3V: Volume — khối lượng rất lớn; Variety — đa dạng về dạng dữ liệu (văn bản, hình ảnh, âm thanh, video, dữ liệu cảm biến...); Velocity — tốc độ phát sinh và cần xử lí rất nhanh.
Phương án A nói ngược hoàn toàn cả ba đặc trưng.
Phương án B và D thu hẹp dữ liệu lớn vào một dạng duy nhất, trái với đặc trưng đa dạng. Thuộc bộ ba 3V theo đúng thứ tự khối lượng – đa dạng – tốc độ là xử lí gọn câu này và cả mảng khoa học dữ liệu phía sau.
Câu 5 — Đáp án A.
Xác thực hai yếu tố (2FA) tạo thêm một lớp bảo vệ ngoài mật khẩu: ngoài điều em biết (mật khẩu), hệ thống còn yêu cầu điều em có (mã xác nhận gửi tới điện thoại hoặc ứng dụng). Nhờ vậy, kẻ xấu dù biết mật khẩu cũng khó đăng nhập được tài khoản. Ba phương án còn lại đều là thói quen nguy hiểm kinh điển: dùng chung một mật khẩu cho mọi tài khoản, đặt mật khẩu là ngày sinh dễ đoán, và chia sẻ mật khẩu cho người khác "giữ hộ".
Câu 6 — Đáp án B.
Mã độc tống tiền (ransomware) xâm nhập vào máy tính, mã hoá dữ liệu của nạn nhân khiến nạn nhân không mở được dữ liệu của chính mình, rồi yêu cầu trả tiền chuộc để đổi lấy khoá giải mã. Đây là một trong những loại mã độc gây thiệt hại lớn nhất hiện nay, và cách phòng chống thực tế nhất chính là sao lưu dữ liệu định kỳ — dữ kiện nối lại với kiến thức an toàn thông tin em đã học từ lớp 10.
Câu 7 — Đáp án C.
Đây là câu hỏi "trục" của chủ đề AI, hỏi lại Câu 2 ở mức sâu hơn: với chương trình truyền thống, con người viết sẵn mọi quy tắc xử lí; với hệ thống học máy, con người cung cấp dữ liệu và thuật toán học, còn cách giải quyết vấn đề (mô hình) được hệ thống tự hình thành từ dữ liệu huấn luyện.
Phương án B sai ở chữ "hoàn toàn": chương trình truyền thống vẫn xử lí dữ liệu đầu vào, chỉ là quy tắc xử lí do người viết sẵn.
Phương án D sai vì học máy vẫn dựa trên thuật toán — thuật toán học — chứ không phải không cần thuật toán.
Câu 8 — Đáp án D.
Mô hình AI học từ dữ liệu huấn luyện; nếu dữ liệu thiếu tính đại diện cho một nhóm người dùng, hoặc bản thân dữ liệu chứa sẵn định kiến của xã hội, mô hình sẽ học theo và khuếch đại sự thiên lệch đó — ví dụ hệ thống nhận diện khuôn mặt được huấn luyện chủ yếu trên ảnh của một nhóm người sẽ nhận diện kém chính xác hơn với các nhóm ít xuất hiện trong dữ liệu. Đây là vấn đề đạo đức trung tâm của AI hiện nay, và cũng là ý c của Câu 1 Phần II dưới một hình thức khác (thiên lệch trong hệ thống gợi ý).
Câu 9 — Đáp án B.
HTTPS là HTTP kết hợp với mã hoá (qua TLS/SSL): nội dung trao đổi giữa trình duyệt và máy chủ được mã hoá, nên kẻ nghe lén trên đường truyền không đọc được và khó sửa đổi dữ liệu. Điểm khác biệt cốt lõi là an toàn, không phải tốc độ (phương án A), không phải loại trang web (phương án C), và dĩ nhiên vẫn cần trình duyệt để truy cập (phương án D). Nhận diện nhanh khi lướt web: ổ khoá trên thanh địa chỉ và tiền tố https là dấu hiệu của kết nối đã mã hoá.
Câu 10 — Đáp án A.
Tường lửa (firewall) giám sát và kiểm soát lưu lượng mạng ra vào hệ thống theo các quy tắc an toàn đã đặt ra, chặn những kết nối không được phép và cho qua những kết nối hợp lệ — giống như người gác cổng kiểm tra giấy tờ của mọi lượt ra vào. Nó không tăng dung lượng ổ cứng, không soạn thảo văn bản và không phải thiết bị kết nối máy in. Ba câu 5, 9, 10 cùng Câu 6 tạo thành trọn bộ "phòng thủ bốn lớp" của mảng bảo mật: 2FA bảo vệ tài khoản, HTTPS bảo vệ đường truyền, tường lửa bảo vệ hệ thống mạng, sao lưu bảo vệ dữ liệu trước ransomware.
Câu 11 — Đáp án D.
Hình ảnh và giọng nói trong cuộc gọi video hoàn toàn có thể bị làm giả bằng công nghệ deepfake, và tình huống trong đề chứa đủ hai dấu hiệu lừa đảo kinh điển: tạo khẩn cấp ("chuyển tiền gấp, đang gặp nạn") và cô lập nạn nhân ("dặn không được nói với ai"). Hành động đúng là bình tĩnh kiểm chứng qua một kênh độc lập, tin cậy — gọi lại bằng số điện thoại quen thuộc, hoặc hỏi một chi tiết chỉ người thân thật mới biết — trước khi thực hiện bất kì giao dịch nào. Chuyển tiền ngay (A) là rơi đúng bẫy; đăng video lên mạng hỏi ý kiến (B) vừa chậm vừa làm lộ thông tin; mặc kệ đến hôm sau (C) bỏ qua khả năng người thân thật sự cần giúp — kiểm chứng mới là bước đi đúng, chứ không phải thờ ơ.
Câu 12 — Đáp án C.
Dữ liệu vừa thu thập thường chứa lỗi, giá trị thiếu, bản ghi trùng lặp và định dạng không thống nhất; nếu đem huấn luyện mô hình hay phân tích ngay trên dữ liệu thô, kết quả sẽ sai lệch — "rác vào thì rác ra". Vì vậy, ngay sau thu thập là bước làm sạch và tiền xử lí dữ liệu, rồi mới tới phân tích và huấn luyện mô hình, cuối cùng là công bố kết quả. Học quy trình khoa học dữ liệu như một dây chuyền có thứ tự cố định: thu thập — làm sạch — phân tích — trình bày kết quả; đề chỉ cần em nhớ vị trí của bước làm sạch nằm ngay sau thu thập.
Đáp án và phân tích Phần II (đúng – sai)
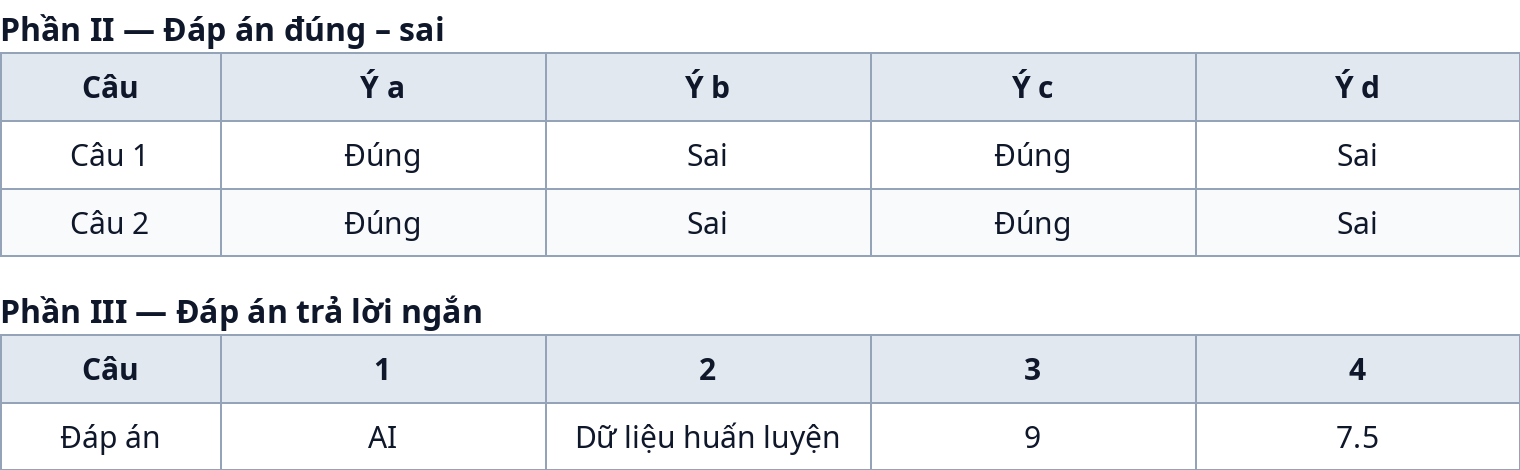
Câu 1 (về hệ thống gợi ý của nền tảng xem video):
- Ý a — Đúng. Hệ thống theo dõi lịch sử xem và tự cải thiện độ chính xác của gợi ý theo thời gian — đó chính là biểu hiện của học máy: mô hình học từ dữ liệu hành vi của người dùng thay vì chạy một quy tắc cố định.
- Ý b — Sai. Bẫy phủ nhận bản chất học máy: nếu lập trình viên phải viết sẵn quy tắc gợi ý cho từng người dùng và từng video, đó là chương trình truyền thống — và thực tế cũng không thể viết nổi, vì số người dùng và số video đều ở mức hàng triệu. Trong hệ thống gợi ý thật, lập trình viên xây dựng thuật toán học, còn quy tắc gợi ý cụ thể do mô hình tự hình thành từ dữ liệu.
- Ý c — Đúng. Dữ liệu huấn luyện thiếu đa dạng sẽ khiến gợi ý thiên lệch, chỉ tập trung vào một số loại nội dung nhất định — người dùng bị "nhốt" trong một vòng lặp nội dung hẹp. Đây là cùng một cơ chế thiên lệch dữ liệu với Câu 8 Phần I, chỉ khác lĩnh vực ứng dụng.
- Ý d — Sai. Bẫy tuyệt đối hoá năng lực AI: các hệ thống AI hiện nay đều là AI hẹp (AI yếu) — giỏi trong một lĩnh vực cụ thể như gợi ý video, nhận dạng giọng nói — chứ chưa có tư duy, cảm xúc và ý thức như con người. Mọi khẳng định tuyệt đối kiểu "mọi hệ thống AI đều đã..." trong đề thi gần như luôn là ý sai.
Câu 2 (về đoạn chương trình đếm điểm):
Đoạn chương trình trong đề duyệt danh sách diem = [8, 5, 9, 4, 7], tăng biến dem mỗi khi gặp phần tử lớn hơn hoặc bằng 5, rồi in dem.
- Ý a — Đúng. Cấu trúc vòng lặp cộng với điều kiện if d >= 5 và lệnh dem = dem + 1 trong khối if cho thấy chương trình đếm số phần tử trong danh sách có giá trị lớn hơn hoặc bằng 5.
- Ý b — Sai. Bẫy đếm theo số phần tử của danh sách: danh sách có 5 phần tử, nhưng phần tử 4 không thoả mãn điều kiện >= 5. Các phần tử thoả mãn là 8, 5, 9, 7 — tổng cộng 4 phần tử, nên kết quả in ra là 4, không phải 5.
- Ý c — Đúng. Lệnh dem = dem + 1 nằm bên trong khối lệnh của if, nên nó chỉ được thực hiện khi điều kiện đúng — tức mỗi lần vòng lặp gặp một phần tử lớn hơn hoặc bằng 5, biến dem mới tăng thêm 1. Đọc vị trí thụt lề của lệnh là đọc được logic này.
- Ý d — Sai. Bẫy thay đổi điều kiện biên: nếu đổi điều kiện thành d > 5, phần tử có giá trị đúng bằng 5 sẽ bị loại; các phần tử thoả mãn chỉ còn 8, 9, 7 — kết quả in ra là 3, không phải 4. Đây là cặp bẫy song sinh với ý b: một ý kiểm tra em có đếm đúng theo điều kiện gốc, một ý kiểm tra em có nhạy với dấu bằng trong điều kiện hay không.
Đáp án Phần III (trả lời ngắn)
Câu 1 — Đáp án: AI.
"Trí tuệ nhân tạo" trong tiếng Anh là Artificial Intelligence, viết tắt AI. Đây là câu mở đầu tặng điểm của phần trả lời ngắn — nhưng cũng là thuật ngữ em sẽ gặp trong mọi tài liệu công nghệ từ nay về sau, nên thuộc luôn cách viết đầy đủ.
Câu 2 — Đáp án: Dữ liệu huấn luyện.
Tập dữ liệu dùng trong giai đoạn huấn luyện để mô hình học và rút ra quy luật được gọi là dữ liệu huấn luyện (tập huấn luyện). Phân biệt với dữ liệu kiểm tra — tập dữ liệu riêng dùng để đánh giá mô hình sau khi học xong; đề chỉ hỏi tập dùng để học.
Câu 3 — Đáp án: 9.
Chạy thử từng bước: range(1, 7, 2) sinh ra các giá trị bắt đầu từ 1, mỗi lần tăng thêm 2 (bước nhảy 2), và dừng trước 7 — tức i lần lượt là 1, 3, 5. Biến s cộng dồn: s = 1 + 3 + 5 = 9. Chương trình in ra 9. Hai bẫy ở câu này: cộng cả số 7 vào (range không bao giờ chạm giá trị cuối) và liệt kê sai dãy thành 1, 3, 5, 7. Khi gặp range có ba tham số, hãy viết dãy giá trị ra giấy trước khi tính.
Câu 4 — Đáp án: 7.5.
Chạy thử từng bước: hàm tb(a, b) trả về (a + b) / 2. Lời gọi tb(6, 9) cho (6 + 9) / 2 = 15 / 2 = 7.5. Chương trình in ra 7.5. Lưu ý phép chia trong Python luôn cho kết quả số thực nên đáp án là 7.5 chứ không phải 7 — đây là chi tiết mà nhiều bạn mất điểm vì quen chia lấy phần nguyên trong toán học.
Gợi ý chấm Phần IV (tự luận)
Bài 1 (1,5 điểm) — Tác hại của deepfake và trách nhiệm khi sử dụng AI.
a) (0,75 điểm) Tác hại của video deepfake (phần tái hiện, 0,5 điểm — nêu được cả hai phía): đối với cá nhân bị giả mạo — danh dự, uy tín và hình ảnh bị tổn hại nghiêm trọng, có thể kéo theo hậu quả trong công việc và đời sống, dù người đó hoàn toàn không nói những điều trong video; đối với cộng đồng — người xem bị đánh lừa, hình thành nhận thức và cảm xúc sai lệch, bức xúc và chia sẻ tiếp khiến thông tin giả lan rộng, gây hoang mang, chia rẽ; về lâu dài, deepfake làm xói mòn niềm tin của xã hội vào mọi nội dung nghe nhìn, đến mức ngay cả video thật cũng bị nghi ngờ. Phần liên hệ (0,25 điểm): tình huống cho thấy AI khi bị lạm dụng trở thành công cụ tạo tin giả tinh vi, khó phát hiện bằng mắt thường hơn hẳn tin giả dạng văn bản trước đây — nên mức độ nguy hiểm của nó cao hơn và trách nhiệm kiểm chứng của người tiếp nhận cũng nặng hơn.
b) (0,75 điểm) Trách nhiệm của người dùng mạng xã hội (phần giải thích, 0,5 điểm — nêu được ít nhất 3 ý): không chia sẻ vội vàng khi nội dung chưa được kiểm chứng, nhất là nội dung gây sốc, kích động cảm xúc mạnh; kiểm tra nguồn đăng và đối chiếu với các nguồn tin chính thống trước khi tin và chia sẻ; báo cáo nội dung giả mạo cho nền tảng; hiểu rằng mỗi lượt chia sẻ thiếu kiểm chứng đều góp phần khuếch đại tin giả và gây hại cho người bị giả mạo. Nguyên tắc phát triển và sử dụng AI có trách nhiệm (phần phân tích, 0,25 điểm): minh bạch — gắn nhãn rõ nội dung do AI tạo ra; tôn trọng quyền riêng tư và hình ảnh cá nhân của người khác; không dùng AI để giả mạo, lừa đảo; bảo đảm công bằng, tránh thiên lệch trong dữ liệu và mô hình; và con người phải chịu trách nhiệm cuối cùng về sản phẩm do AI tạo ra, không đổ lỗi cho "máy làm".
Bài 2 (1,5 điểm) — Viết chương trình Python thống kê nhiệt độ 7 ngày.
a) (0,75 điểm) Chương trình tính nhiệt độ trung bình (chấm theo từng ý: khởi tạo biến tổng và duyệt đúng danh sách 0,25 điểm; cộng dồn đúng các giá trị 0,25 điểm; chia cho số phần tử bằng len(nhiet) và in kết quả 0,25 điểm):
nhiet = [31, 33, 30, 35, 32, 34, 33] tong = 0 for t in nhiet: tong = tong + t print("Nhiet do trung binh:", tong / len(nhiet))Kiểm chứng kết quả trước khi nộp: tổng nhiệt độ = 31 + 33 + 30 + 35 + 32 + 34 + 33 = 228; nhiệt độ trung bình = 228 / 7 ≈ 32,57 độ C (chương trình in ra dãy số thập phân dài 32.57142857142857). Dùng len(nhiet) thay vì viết cứng số 7 là thói quen tốt: chương trình vẫn đúng khi danh sách thay đổi độ dài.
b) (0,75 điểm) Phần bổ sung đếm ngày nóng (chấm theo từng ý: thêm biến đếm và điều kiện t >= 33 đúng vị trí trong vòng lặp 0,25 điểm; in số ngày nóng 0,25 điểm; nêu đúng cả hai kết quả in ra 0,25 điểm):
nhiet = [31, 33, 30, 35, 32, 34, 33] tong = 0 dem = 0 for t in nhiet: tong = tong + t if t >= 33: dem = dem + 1 print("Nhiet do trung binh:", tong / len(nhiet)) print("So ngay nong:", dem)Kiểm chứng: các ngày có nhiệt độ từ 33 độ C trở lên là 33, 35, 34, 33 — tổng cộng 4 ngày, nên dem = 4. Chương trình hoàn chỉnh in ra nhiệt độ trung bình xấp xỉ 32,57 độ C và số ngày nóng là 4. Hai chi tiết dễ mất điểm ở ý này: đặt lệnh đếm ra ngoài vòng lặp (chỉ xét được ngày cuối cùng) và viết điều kiện thành t > 33 làm rơi mất hai ngày đúng 33 độ — cùng một loại bẫy điều kiện biên đã xuất hiện ở Câu 2 Phần II và Câu 4 Phần III của các đề trước.
Thang điểm chi tiết của đề
Để tự chấm bài sau khi làm, em đối chiếu theo thang điểm sau:
- Phần I: 12 câu × 0,25 điểm = 3,0 điểm (mỗi câu đúng 0,25 điểm, sai hoặc bỏ trống 0 điểm)
- Phần II: 2 câu × 1,0 điểm = 2,0 điểm. Mỗi câu chấm lũy tiến theo số ý đúng: đúng 1 ý được 0,1 điểm; đúng 2 ý được 0,25 điểm; đúng 3 ý được 0,5 điểm; đúng cả 4 ý được 1,0 điểm. Vì thang lũy tiến dốc mạnh ở ý thứ 4, một ý sai làm mất nhiều hơn em tưởng: đúng 3/4 ý chỉ còn 0,5 điểm thay vì 0,75 như cách tính tuyến tính quen thuộc — hãy xét từng ý thật độc lập, đặc biệt cảnh giác với các ý tuyệt đối hoá năng lực AI ("mọi hệ thống AI đều đã có tư duy như con người") và các ý thay đổi lặng lẽ điều kiện biên trong câu đọc chương trình
- Phần III: 4 câu × 0,5 điểm = 2,0 điểm (chỉ chấm đáp án cuối cùng; với câu đọc chương trình, đáp án là kết quả in ra sau khi chương trình chạy xong — chú ý kết quả số thực như 7.5 phải giữ nguyên dạng thập phân)
- Phần IV: 2 bài × 1,5 điểm = 3,0 điểm, chấm theo từng bước như gợi ý chấm ở trên: Bài 1 tách bạch phần nêu tác hại với phần trách nhiệm người dùng và nguyên tắc AI có trách nhiệm; Bài 2 chấm theo từng ý kĩ thuật và cả kết quả chạy chương trình được nêu ra
Tổng cộng 10,0 điểm. Trên hệ thống ClassOn, điểm được quy đổi sang thang 40. Gợi ý phân bổ 90 phút làm bài: Phần I khoảng 15 phút, Phần II khoảng 12 phút, Phần III khoảng 13 phút (hai câu khái niệm làm nhanh, hai câu đọc chương trình cần liệt kê dãy giá trị của range và chạy nhẩm cẩn thận), Phần IV khoảng 40 phút, chừa khoảng 10 phút cuối để soát lại ba việc: các khẳng định tuyệt đối về AI đã được xét độc lập chưa, dãy giá trị của range(1, 7, 2) đã liệt kê đúng 1 – 3 – 5 chưa, và chương trình ở Bài 2 đã nêu đúng cả hai kết quả in ra chưa — với đề Tin học 12, phần lớn điểm mất oan nằm ở ba thao tác soát này.
Làm đề trực tuyến trên ClassOn
Đọc đề và đáp án trong bài viết giúp em hiểu cách giải, nhưng cảm giác thi thật chỉ có khi bấm giờ và tự làm trọn vẹn trong 90 phút. Em có thể làm đề kiểm tra giữa kỳ 1 Tin học 12 trực tuyến ngay trên ClassOn:
- Đồng hồ đếm ngược 90 phút như phòng thi, giúp em tập phân bổ thời gian cho cả bốn phần trắc nghiệm và tự luận.
- Phần trắc nghiệm khách quan (Phần I, II, III) được chấm tự động ngay khi nộp bài — em biết mình mất điểm ở câu nào, kể cả thang lũy tiến của câu đúng – sai.
- Xem đề thi công khai không cần đăng nhập; chỉ khi muốn nộp bài và lưu kết quả, em mới cần một tài khoản ClassOn miễn phí.
- Giáo viên cũng có thể tạo lớp miễn phí trên ClassOn và giao chính đề này cho học sinh làm, rồi dùng gợi ý chấm và thang điểm chi tiết trong bài viết này để chấm, nhận xét phần tự luận của học sinh.
Cách ôn tập theo từng chủ đề của đề
Chủ đề 1 — Trí tuệ nhân tạo và học máy (3,0 điểm, nền của cả đề). Toàn bộ mảng này treo trên một trục duy nhất: chương trình truyền thống được viết sẵn mọi quy tắc; hệ thống học máy tự hình thành quy tắc (mô hình) từ dữ liệu huấn luyện. Từ trục đó suy ra mọi câu còn lại: ứng dụng AI là những hệ thống có học hỏi, nhận dạng, suy luận (trợ lí ảo, gợi ý video); dữ liệu huấn luyện thiếu đại diện thì mô hình thiên lệch; AI hiện nay là AI hẹp, chưa có ý thức và cảm xúc. Học thuộc trục này kèm hai thuật ngữ "dữ liệu huấn luyện" và "AI là viết tắt của Artificial Intelligence" là xử lí gọn Câu 1, 2, 3, 7 Phần I, cả hai ý khó của Câu 1 Phần II và Câu 1, 2 Phần III.
Chủ đề 2 — Đạo đức AI và an toàn thông tin cá nhân (0,5 điểm ở Phần I, 1,5 điểm ở Bài 1 Phần IV). Hai tình huống phải thuộc như phản xạ: cuộc gọi video người thân xin chuyển tiền gấp có thể là deepfake — kiểm chứng qua kênh độc lập trước khi chuyển; video người nổi tiếng phát biểu gây sốc có thể là deepfake — kiểm chứng nguồn trước khi chia sẻ. Kèm theo đó là khung nguyên tắc AI có trách nhiệm: minh bạch (gắn nhãn nội dung AI), tôn trọng riêng tư và hình ảnh cá nhân, không giả mạo – lừa đảo, công bằng – không thiên lệch, con người chịu trách nhiệm cuối cùng. Khung này là nguyên liệu trực tiếp cho cả hai ý của Bài 1 Phần IV.
Chủ đề 3 — Bảo mật thông tin (1,0 điểm). Học theo mô hình phòng thủ bốn lớp: tài khoản có 2FA; đường truyền có HTTPS mã hoá; hệ thống mạng có tường lửa gác cổng; dữ liệu có sao lưu định kỳ để chống ransomware. Mỗi lớp gắn với đúng một câu trong đề (Câu 5, 9, 10 và 6), học theo sơ đồ lớp như vậy sẽ không bao giờ gán nhầm chức năng giữa các biện pháp.
Chủ đề 4 — Khoa học dữ liệu và lập trình xử lí dữ liệu (4,0 điểm, nặng nhất đề). Phần khái niệm chỉ cần hai khối: bộ ba 3V của dữ liệu lớn (khối lượng, đa dạng, tốc độ) và quy trình bốn bước có thứ tự (thu thập — làm sạch — phân tích — công bố), trong đó bước làm sạch nằm ngay sau thu thập. Phần lập trình cần luyện ba kĩ năng: liệt kê dãy giá trị của range có bước nhảy trước khi cộng dồn; đọc hàm tự định nghĩa bằng cách thay số vào tham số rồi tính biểu thức return; và viết chương trình thống kê hoàn chỉnh (tổng, trung bình bằng len, đếm có điều kiện) trong một vòng lặp duy nhất — đúng cấu trúc của Bài 2 Phần IV.
Lộ trình ôn 3 buổi gợi ý:
- Buổi 1: Ôn Chủ đề 1; vẽ sơ đồ đối chiếu chương trình truyền thống — học máy và học thuộc trục "mô hình học từ dữ liệu"; làm lại Phần I Câu 1–4, 7, 8, Phần II Câu 1 và Phần III Câu 1, 2.
- Buổi 2: Ôn Chủ đề 2 và Chủ đề 3; học khung nguyên tắc AI có trách nhiệm và sơ đồ phòng thủ bốn lớp; làm Phần I Câu 5, 6, 9–12 và viết dàn ý Bài 1 Phần IV theo hai ý tác hại — trách nhiệm.
- Buổi 3: Ôn Chủ đề 4; luyện đọc range có bước nhảy và hàm tự định nghĩa (Phần III Câu 3, 4), viết trọn Bài 2 Phần IV kèm kiểm chứng kết quả bằng tính tay; sau đó làm trọn đề trong 90 phút trên ClassOn và tự chấm bằng thang điểm chi tiết.
Lỗi sai thường gặp — những cái bẫy mất điểm đáng tiếc nhất ở đề này
- Lẫn lộn chương trình truyền thống với học máy (Câu 2, Câu 7 Phần I, ý b Câu 1 Phần II). Đây là bẫy trung tâm của đề, xuất hiện ba lần dưới ba hình thức: chọn nhầm định nghĩa, chọn nhầm điểm khác biệt, và nhận định sai về hệ thống gợi ý. Cách tránh: thuộc một câu duy nhất — "học máy là tự rút quy luật từ dữ liệu" — và mỗi khi thấy phương án nào nói "viết sẵn quy tắc cho mọi tình huống", hãy gán nó cho chương trình truyền thống.
- Liệt kê sai dãy giá trị của range có bước nhảy (Câu 3 Phần III). range(1, 7, 2) cho 1, 3, 5 — rất nhiều bạn cộng cả 7 vào thành 16, hoặc liệt kê thành 1, 3, 5, 7. Cách tránh: viết dãy giá trị ra giấy theo quy tắc "bắt đầu từ số đầu, cộng dần bước nhảy, dừng ngay trước số cuối" rồi mới bắt đầu cộng dồn, không tính nhẩm trong đầu.
- Đếm sai vì bỏ qua điều kiện biên lớn hơn hoặc bằng (ý b, ý d Câu 2 Phần II). Trong danh sách [8, 5, 9, 4, 7], điều kiện >= 5 cho 4 phần tử nhưng điều kiện > 5 chỉ cho 3 phần tử, vì phần tử đúng bằng 5 bị loại. Cách tránh: khi chạy nhẩm, xét từng phần tử và đánh dấu riêng những phần tử nằm đúng tại biên của điều kiện — đó luôn là nơi đề cài bẫy.
- Tuyệt đối hoá năng lực của AI (ý d Câu 1 Phần II và các phương án nhiễu dạng "mọi", "luôn luôn", "hoàn toàn"). AI hiện nay là AI hẹp: giỏi một việc cụ thể, không có tư duy, cảm xúc, ý thức như người. Cách tránh: gặp khẳng định chứa từ tuyệt đối về năng lực AI, mặc định nghi ngờ và xét thật kĩ — trong chương trình phổ thông, những khẳng định như vậy gần như luôn sai.
- Tin ngay vào cuộc gọi video và nội dung gây sốc trên mạng (Câu 11 Phần I, Bài 1 Phần IV). Deepfake làm giả được cả khuôn mặt lẫn giọng nói, nên "mắt thấy tai nghe" không còn là bằng chứng nữa. Hai dấu hiệu phải thuộc như phản xạ: yêu cầu chuyển tiền gấp và dặn giữ bí mật. Cách tránh: thuộc quy trình "dừng — kiểm chứng qua kênh độc lập — mới hành động": gọi lại số quen thuộc, hỏi chi tiết chỉ người thật mới biết, đối chiếu nguồn tin chính thống trước khi tin, chia sẻ hay chuyển tiền.
Câu hỏi thường gặp
Hỏi: Đề kiểm tra giữa kỳ 1 Tin học 12 trên ClassOn có miễn phí không?
Đáp: Có. ClassOn miễn phí 100% — xem đề, làm bài, xem đáp án và giải thích đều không thu phí, không có gói trả tiền ẩn.
Hỏi: Phần đúng – sai của đề được chấm điểm như thế nào?
Đáp: Mỗi câu đúng – sai gồm 4 ý, chấm lũy tiến: đúng 1 ý được 0,1 điểm; đúng 2 ý được 0,25 điểm; đúng 3 ý được 0,5 điểm; đúng cả 4 ý mới được trọn 1,0 điểm. Đây là thang điểm theo cấu trúc đề kiểm tra định kỳ cấp THPT hiện hành — em nên làm quen sớm, vì phần này rất dễ mất điểm ở các ý thay đổi lặng lẽ điều kiện biên của chương trình hoặc tuyệt đối hoá năng lực AI, nếu xét các ý một cách vội vàng.
Hỏi: Đề Tin học 12 có nhiều nội dung thời sự như deepfake và AI, em ôn theo sách giáo khoa có đủ không?
Đáp: Đủ. Mọi câu hỏi thời sự trong đề đều bám vào các khái niệm đã có trong chương trình: học máy và dữ liệu huấn luyện, thiên lệch dữ liệu, đạo đức AI, bảo mật thông tin. Tình huống chỉ là cái vỏ; lõi kiến thức vẫn là sách giáo khoa. Phần giải thích trong bài này đã chỉ rõ từng tình huống gắn với khái niệm nào, nên em cứ ôn khái niệm cho chắc rồi luyện áp vào tình huống.
Hỏi: Xem và làm đề có cần đăng nhập không?
Đáp: Xem đề thi công khai và đọc đáp án, giải thích trong bài viết này không cần đăng nhập. Nếu muốn nộp bài, xem điểm chấm tự động và lưu kết quả trên hệ thống, em cần một tài khoản ClassOn miễn phí.
Hỏi: Đề này có khớp với tiến độ giữa kỳ 1 ở trường em không?
Đáp: Đề biên soạn theo sách Kết nối tri thức với cuộc sống, phạm vi là các chủ đề mở đầu của Tin học 12: trí tuệ nhân tạo và ứng dụng, mở đầu mạng máy tính và bảo mật thông tin, giới thiệu khoa học dữ liệu — đúng tiến độ nửa đầu học kỳ 1 của đa số trường. Học sinh học các bộ sách khác vẫn dùng đề này để ôn tốt, vì AI, dữ liệu lớn và an toàn thông tin là nội dung phổ quát của chương trình Tin học 12 hiện hành; chỉ cần lưu ý tiến độ từng trường có thể chênh nhau một vài bài.
Hỏi: Giáo viên có thể dùng đề này cho lớp của mình không?
Đáp: Hoàn toàn được: tạo lớp miễn phí trên ClassOn, giao đề cho học sinh làm trực tuyến có bấm giờ và chấm tự động phần trắc nghiệm khách quan, và dùng gợi ý chấm cùng thang điểm chi tiết trong bài viết này để chấm, nhận xét phần tự luận của học sinh.
Tài liệu liên quan và đề thi tiếp theo
Đề Tin học 12 này thuộc đợt đề kiểm tra giữa kỳ 1 các môn lớp 6–12 đang được ClassOn đăng tải dần lên kho đề thi công khai — vào Xem đề thi công khai để làm bài ngay, hoặc xem toàn bộ danh sách đề tại kho đề thi công khai của ClassOn để chọn thêm đề các môn, các lớp khác, trong đó có đề giữa kỳ 1 Tin học 10 (biểu diễn thông tin, mạng máy tính, Python cơ bản) và Tin học 11 (cơ sở dữ liệu và truy vấn SQL) cùng đợt — ba đề Tin học của ba lớp tạo thành một mạch liền: nền tảng máy tính, rồi dữ liệu, rồi trí tuệ nhân tạo.
Chúc em ôn tập hiệu quả: với Tin học 12 giữa kỳ 1, điểm số quyết định ở ba thói quen — luôn hỏi "mô hình này học từ dữ liệu nào", liệt kê dãy giá trị của range ra giấy trước khi tính, và kiểm chứng qua kênh độc lập trước mọi nội dung gây sốc hoặc yêu cầu chuyển tiền trên mạng. Học tốt nhé!